Q-Logo 我的学习笔记分享

Entries for category "python"

用Python 将图片中的白色背景改为透明

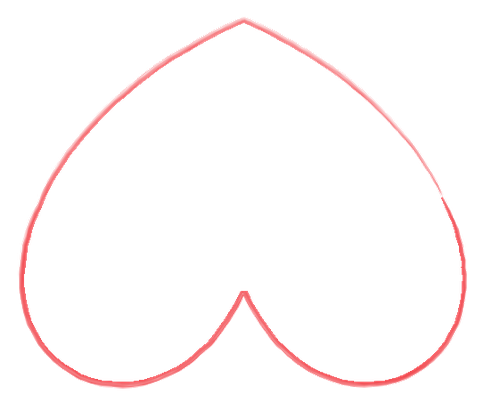
原始白色背景图片是这样的

爱心.png

希望处理后,爱心外面和里面的白色背景都变成透明的,像这样

爱心透明背景.png

代码

import PIL.Image as Image

img_file = 'C:\\Pictures\\爱心.png'

output_file = 'C:\\Pictures\\爱心透明背景.png'

img = Image.open(img_file)

img = img.convert('RGBA')

W, H = img.size

white_pixel = (255, 255, 255, 255)

for h in range(H):

for w in range(W):

if img.getpixel((w,h)) == white_pixel:

img.putpixel((w,h),(255,255,255,0))

img.save(output_file)
Pandas DataFrame的round函数详解及小坑

df.round(decimals=0, *args, **kwargs)

输入参数

decimals : int, dict, Series,每一列舍入到的小数位数。如果是整数,每一列都被舍入到这个位数;如果是字典或序列,各列舍入到指定的精度。列的名字应该作为decimals 字典的键,或者decimals 序列的index。未在decimals 中指定精度的列将保留原样。如果decimals 中有不是列名的键或index,会被忽略。

返回:

DataFrame: 舍入到指定精度的DataFrame。

decimals=0时,返回的是浮点数而非整数。

round 并非四舍五入,对浮点数执行round 须谨慎。

从Python 的round 函数的坑谈四舍五入

对浮点数执行 round ,返回的不是四舍五入的值,而是按以下规则确定的:

  1. 值会被舍入到距离 number 最接近的 10 的负 ndigits 次幂的倍数
  2. 如果 number 与两个倍数的距离正好相等,则选择偶数,即正好在中间时,向偶取整

我们输入和看到的浮点数,与计算机中存储和运算时使用的浮点数未必完全相同,多数时候后者只是前者的近似值。

round(2.675, 2) 返回2.67 而不是 2.68 ,并不是错误,也不是bug,而是使用计算机进行浮点运算必然会出现的现象。

除非对精确度要求比较底,否则尽量避免用round()函数处理浮点小数。

如果确实需要使用四舍五入的方式进行舍入,可以用 decimal 模块:

>>> import decimal

>>> D = decimal.Decimal

>>> decimal.getcontext().rounding = "ROUND_HALF_UP" # 设置舍入方式为四舍五入

>>> D('2.675').quantize(D('0.00'))

Decimal('2.68') # 四舍五入后的值

在Wagtail 网站中为自定义内容类型创建 API 端点路径

在 在Wagtail网站中提供 RESTful API 服务 一文中,介绍了怎样为Wagtail 内置的页面、图片、文档 等类型的内容配置API 端点路径,其中也提到,如果要增加新的内容类型,可以继承路径基类 wagtail.api.v2.views.BaseAPIViewSet ,本文以类型为BlogCategory 的Snippet 为例,介绍怎样为其创建API 路径端点。创建好之后,API 响应如下:

{
"meta": {
"total_count": 2
},
"items": [
{
"id": 1,
"meta": {
"type": "blog.BlogCategory",
"detail_url": "http://api.example.com/api/v2/categories/1/",
},
"name": "Test",
"slug": "category-test-1"
},
{
"id": 2,
"meta": {
"type": "blog.BlogCategory",
"detail_url": "http://api.example.com/api/v2/categories/2/",
},
"name": "Hello",
"slug": "category-test-2"
}
]
}

Pandas数据整理实战 - 合并+填充+丢弃缺失

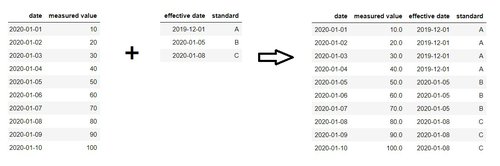
在进行数据处理时,有时会需要将这样的两个表整理成一个表,如下图所示

pandas-merge-fillna-dropna.jpg

第一个表中为每日测量值,第二个表中是标准生效日期,第一个表中每日的测量值,是依据当日之前最新的标准进行测量得到的值。按照这个规则可以整理得到第三个表,这个表综合显示每日测量值所依据的标准和标准生效日期。

使用pandas , 可以综合运用合并、填充和丢弃缺失等方法,来从表1和表2得到表3:

pdm = pd.merge(df1,df2,how='outer',left_on='date',right_on='effective date',sort=True).fillna(method='ffill').dropna()